2018年8月26日日曜日

自動運転をめぐる"思想"

安全重視かお金重視か。自動運転実現に向けた思想の話をします。


自動運転は二つある


自動運転と聞いて最初に思い浮かべる会社はどこでしょうか。
最先端っぽいGoogleか、2018年5月に事故を起こして話題になったUberか
話題性盛りだくさんのTeslaか、バスを方々で走らせているSBDriveか


他にも自動車メーカー、ITメーカー、Startupなどたくさんあります。

昨今のニュースではなんでもかんでも「自動運転」。
しかも「レベル3」とか「レベル5」とか、レベル付けまでされています。


しかし正直、レベル付けなんてどうでもよくて
あなたは安全重視か、それともお金重視か
というところがとっても大事です。

設計思想が全く違う


安全重視というのは、以下のような機能を載せた自動運転。(レベルで言うと0~2)
この派閥の人達はどうすれば事故を減らせるかに興味があります。

  • 緊急ブレーキ・レーン逸脱防止のようにドライバーのミスを補う機能
  • レーン維持などドライバーの負荷を減らす機能 

一方お金重視は、バスやカーシェアを使った新しいビジネスを狙った完全自動運転。(レベル4~5)
この派閥の人達はどうすればお金が稼げるかに興味があります。

  • 公共交通のない地方の新しい交通手段
  • シャトルバスの無人化
  • 配車・駐車を自動化し効率化されたカーシェア
    (空車の場合は駐車する、ユーザーの家の前まで迎えに行く、など)


この二つの自動運転がどれくらい違うかをスターウォーズで例えると、
ドロイドとクローンくらい違います。


ドロイドはジェダイの戦闘機操縦を助けてくれます。
いろんな情報も教えてくれます。人間にはできないデータ処理もします。
クローン兵はタイファイターの出撃から帰還まで完璧にこなすことができます。

しかし目的が違う以上、二つは異なる進化を遂げます。
ドロイドがクローン兵になることは何年かかってもないです。

そう、この二つの自動運転、全く違うんです。

クローン兵(Chauffeur) vs ドロイド(Guardian)

この思想は基本的に相容れない宗派のようなものです。

安全重視というのは中々に茨の道です。毎日何百万台も作る車には当然機械としての誤差が産まれます。乗り手もさまざまな運転をします。年に数回しか運転しないようなドライバーもいれば、毎日運転するドライバーもいて、どちらも必ず事故を起こします。速度制限なんて概ね守られていません。(例: 左折時徐行してる車なんて半分もいない)

安全機能なんて保険と同じようなもので、ビジネスとしてめちゃめちゃ儲かるものでもないはずです。それでも事故を減らしたい、そういう人達がGuardian派になるわけです。


一方お金重視(Chauffeur派)はリスクは少ないです。何百万台もいきなり作るわけでもないし、ビジネスモデルさえ確立すればセンサーはいくらでもつけられる。初期投資にお金をかけられます。乗用車やトラックの価格が今の倍になるとなれば大騒ぎですが、ロボットカーが何百万円してもそんなに気にする必要がないのです。

自動運転は技術的に成熟してきている、と信じている人はこのChauffeur派になりやすいです。私はGuardian派で、無事故達成できればChauffeur派に転身予定です。


以上を踏まえて、自動運転のレベルを2派に分類するとこうなります。


市販の車は概ね安全派に分類され、お金派はそれらと全く異なるセンサーや車でLevel 4を実現します。が、双方を兼ね備えるLevel 3とか、どこでも完全Level 5なんてものは未来永劫登場しないと思っています。今後ニュースで出てくるLevel 3は全てLevel 2に分類できるでしょう。

さいごに

もし自動運転に携わりたいエンジニアがここまで読んだ場合、この派閥はよく考慮して就職活動をすると良いです。R2D2派は自動車メーカーや部品メーカー、クローン兵派はIT企業に行くとマッチング率高いと思います。思想強めな投稿でした、おしまい。

2018年8月6日月曜日

Ubuntuでログインループにハマる2つの理由

Ubuntu (nvidia GPU使用) PCを新規にセットアップしようとすると毎回ハマるので一旦まとめてみます。
(English Instruction is available in github issue)

はじめに  


パスワードを入れるとまたログイン画面に帰ってくる現象、その名もログインループ。


今まではコンソールからログイン(Ctl + Alt + F1)してから
Ubuntuアップデートしたらログインできなくなった(nvidia GPU使用)の通りnvidiaドライバをダウングレード:

sudo dpkg -l | grep nvidia
sudo add-apt-repository ppa:xorg-edgers/ppa
sudo apt-get update
sudo apt-cache search 'nvidia-[0-9]+$'
sudo apt-get install nvidia-352

すればうまくいっていたが、、、今回はsecure bootがオンになっていることが原因でした。

Secure bootをオフにする 


1. まずはコンソールからログイン(Ctrl + Alt + F1)してmodprobe

sudo modprobe nvidia

これで
  • 何も表示されなければsecure bootはオフ (勝ち)
  • Required key not availableと表示されたらsecure bootがオン (2へ進む)

2. オフにするにはPC起動時にF2だかF10だかを連打してこんな画面へ移動 
(参考: Disabling Secure Boot )


3. Bootタブに移動してsecure bootを設定する画面にいければ勝ち確定。
  1. Secure bootをDisabledで選択する
  2. OS TypeをWindows UEFI modeからOther OSに変更する
の2パターンあります(私は後者でした)
おしまい。

(おまけ: ブログでのコマンドラインの説明をおしゃれにキメる)


2018年7月9日月曜日

Windows 7(+GPU)でSSD-Keras動かしてみる

今時はWindows 10なブログが多いですが、Windows 7(+GPU)でDeep Learningしたかったのでそのまとめです。

はじめに


歩行者検知といえばDeep Learning, YOLOかSSDといえばSSDでしょ、という昨今。
今回はKeras (backendはtensorflow)でSSDというこちらを動かします。

環境構築

Python + Tensorflow + Kerasの基本環境はminicondaベースで入れました。
Udacity Nanodegreeのものをベースに色々アップグレードしていきます。

  • Tensorflow: 1.8
  • Keras: 2.1.6
  • Numpy: 1.14.3
  • Beautiful Soup: 4.6.0

GPUない人はこれだけでSSD-Keras動かせますが、GPUある人はもう少し作業が必要です。
ちなみにGPUありなしはデバイスマネージャーで見れます。


GPUある人はcuda9.0cudnn7.0.5 for CUDA 9.0を入れます。
(最新版のcuda9.2とcudnn7.1では動かなかったです)


テスト


あとは

  1. モデルダウンロードして
  2. Jupyter notebook起動して
  3. SSD300_inference.ipynb開けば

動かせます。次は噂のBDD100kとか使って転移学習でもします。
おしまい。

(2018/07/10 追記)
動画およびUSBカメラのパイプラインも書きました

参考

2018年5月20日日曜日

【Python x OpenCV】道路標識のデータセットを拡張

AI(機械学習, 深層学習, ディープラーニング, ニューラルネットワーク)を使って道路標識を分類したい時に使うデータ拡張の備忘録。

データセット拡張 (data augmentation)


ニューラルネットワークで必要になるトレーニング用のデータセット。

German Traffic Sign Datasetの様に枚数があれば良いのですが、
現実には整備済みデータセットはまだまだ少ないというのが現状です。。

そこで必要になるのがデータの水増し。
人工的にデータ増やしてしまおう作戦です。既に


など分かりやすい解説はあるので、

  1. 左右反転
  2. 明るさチェンジ
  3. 上下左右にシフト

の3つのopencvバージョンでも紹介します。
コードはこちらからどうぞ。

1. 左右反転


opencvでの左右反転は
flipped = cv2.flip(img,1)
の一行でおしまいです。1は反転方向を左右に指定してるだけです。ちょろい。

2. 明るさチェンジ


def change_brightness(image):
    image1 = cv2.cvtColor(image,cv2.COLOR_RGB2HSV)
    image1 = np.array(image1, dtype = np.float64)
    # can be changed the brightness at here (currently 2.0)
    random_bright = 2.0 #+np.random.uniform()*.4 
    image1[:,:,2] = image1[:,:,2]*random_bright
    image1[:,:,2][image1[:,:,2]>255]  = 255
    image1 = np.array(image1, dtype = np.uint8)
    image1 = cv2.cvtColor(image1,cv2.COLOR_HSV2RGB)
    return image1

rgb空間だと明るさ変えられないのでhsv空間に変換してからゲインかけてるだけです。
2.0のところを小さくすれば暗くなりますし、ランダムにもできます。ちょろい。

3. 上下左右にシフト


def shift(image,trans_range):
    rows,cols = image.shape[0:2]
    # Translation
    tr_x = trans_range*np.random.uniform()-trans_range/2
    tr_y = trans_range*np.random.uniform()-trans_range/2
    #tr_y = 0
    Trans_M = np.float32([[1,0,tr_x],[0,1,tr_y]])
    image_tr = cv2.warpAffine(image,Trans_M,(cols,rows))
    return image_tr

x, y方向にtrans_rangeに応じたピクセル数だけずらしてるだけです。ちょろい。

ということで、結果はこちら。


関数にしとくとシフトと明るさチェンジの両方適用したりが簡単です。
手前方向に回転(ワープ処理)とかは気が向いたら実装します。

おしまい。

2018年4月1日日曜日

危険な交差点を見つけたのでデータあげた話

おじいちゃんドライバーに轢かれそうになったので激昂しかけたけど、よくよく調べると交差点に問題がある気がしたので方々にデータ上げた話でも書きます。

轢かれそうになった交差点


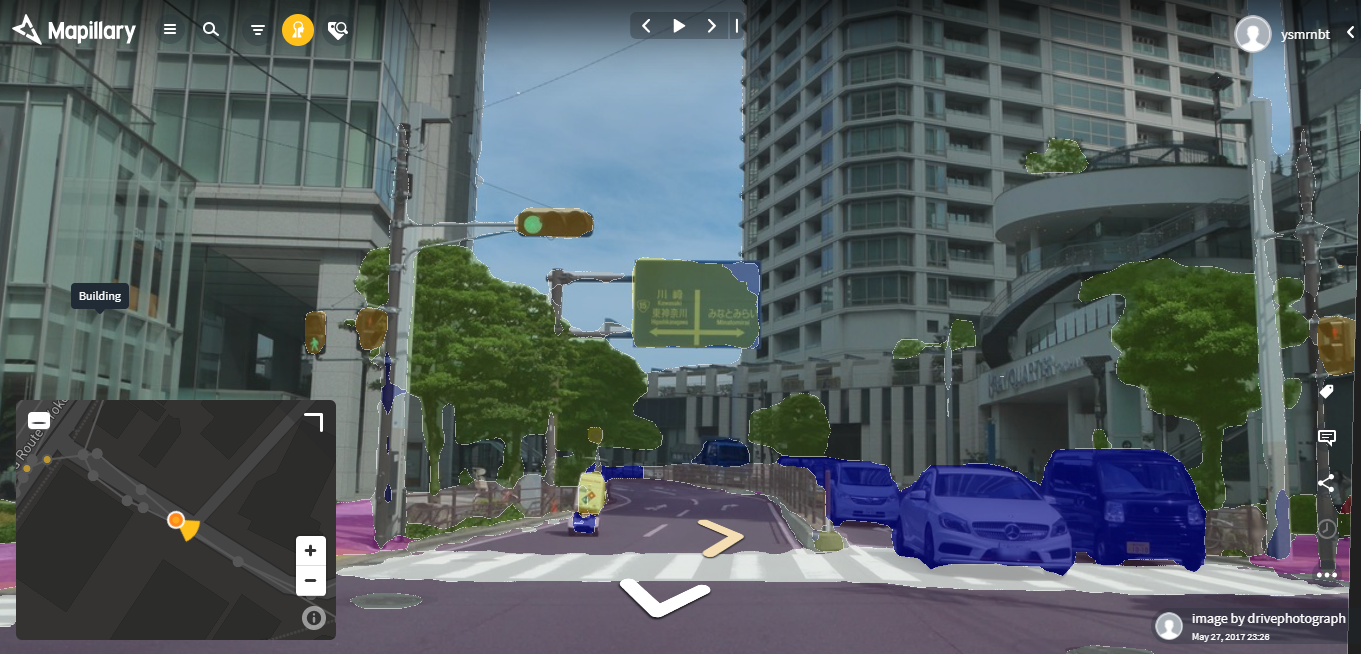
下記Google street viewの道を直進しようとしたら右から猛スピードでおじいちゃん軽が突っ込んできました。


その時はおじいちゃんに毒づいて終わりでしたが、おじいちゃん側が走ってきた道を見てみると中々の難易度であることが判明。


この電柱の左と草の右に道があって交差点になってるんだけど、初見で分かる人いるんですかね、これ。

一応僕側(東→西で交差点進入側)には止まれ標識あります。


しかしおじいちゃん側(北→南で交差点進入)には何の情報もありません。
せめて止まれ標識か停止線があれば自動運転的にもなんとかできるけど、現状は無理ゲーすぎるので4ヶ所に情報あげました。

  1. 警察: webページからメール
  2. 土木事務所: 区のwebページからメール
  3. Safety Map: Hondaが提供している交通安全用地図
  4. Mapillary: Street Viewの全員参加型バージョン

1, 2の反応が悪い場合は先人のように区役所行ってみます。
(参考:「危ない道路」の改善を求めてみたら、意外にすんなり対応してくれた件)

3のSafety Mapはまぁ備忘録的な位置付けなんですが、4のMapillaryは今回初めて見つけました。

Mapillary


ただの画像共有サービスかと思いきや、semantic segmentationがサービスに含まれてたり、データセットも公開してたり、標識認識やその結果をマップ上に重ねるとこまで提供してたり。

すごいぞ、これ。
今まで横断歩道をラベリングしたデータセット全然なかったし。

次回、横断歩道検知、5月中に投稿!(自戒)
おわり。

2018年3月15日木曜日

Dempster Shafer Theory (DST)とかいうやつ

日本語の分かりやすい説明が見当たらないので少し考えてみました(合っているかは保証しません)。

Dempster Shafer Theory (DST)を3行で


Wikiに書いてありますが、ざっくりまとめると
  • ベイズの拡張(一般化)バージョン
  • ベイズよりあいまいさに寛容
  • いろんなデータをfusionするの得意


みたいです。ベイズに関してはWiki含めたくさん解説記事あるのでそちらに任せます。

ベイズの拡張(一般化)バージョン?


例えばベイズのwikiにクッキーの例がありますが、ベイズでは全ての事柄に確率が存在します。ボウル1からプレーンクッキーが出る確率、ボウル2を選ぶ確率、なんでもかんでも確率です。しかし、そんなになんでも確率を計算できるのでしょうか?いくつかイジワルな質問を並べます。

  • ボウルの中でクッキーが割れている確率は?
  • 知らない間に誰かがクッキーを食べていた確率は?
  • クッキーが湿気でくっついている確率は?

これらは極端な例ですが、要はあらゆる事象に確率を付与するのは現実的ではない、という話です。

分からないものは分からない、それでいいじゃないか。
いろんな事柄に重みをつけてミックスして尤もらしい情報を計算しようよ。

こうしてDSTは産まれたのです(適当)。

ベイズよりあいまいさに寛容?


ベイズの定理でググると、P(A)だのP(B)だの出てきます。
ベイズさんはAである確率、Bである確率、みたいな感じでなんでも確率を付与したがります。


でもAかBか分からない場合もあるし、AとB両方だったりAでもBでもない可能性もあるわけです。
これがCとかDとか増えると更にわけわからなくなります。

例えば、家に帰って自分のプリンが冷蔵庫から消えていた時。
家には父、母、妹の3人の容疑者がいます。


父は甘いものが嫌い、母は真面目、妹は前科があるとします。
ベイズ的に考えると圧倒的に妹が不利な条件ですが、DSTはもう少し寛容です。

そもそもプリンは本当に誰かが食べたのか?
もしかしたら誰も食べてなくて移動されただけかもしれない。
間違えて母が捨てたのかもしれない。
自分の記憶違いでもう食べたんじゃないか?

などなど、あらゆる可能性を考えるのですぐに妹に攻撃はしません。

DSTのような大人でありたいものですね(適当)。

いろんなデータをfusionするの得意?


さて、そろそろ真面目な話をすると、ベイズやDSTはoccupancy gridなどでよく使われます。


移動ロボット、自動運転などで障害物の位置を計測・記憶しておくアレです。

ここでノイズのないセンサ1個で障害物を探す場合はベイズさんで余裕ですが、現実はそんなことはありません。
カメラ、レーダー、ライダー、いろんなセンサのいろんな不確定要素を考慮した上で1つのoccupancy gridを算出するのは結構大変です。

そんないろんなセンサ情報をfusionする、いわゆるsensor fusionにおいてDSTは活躍します。


DSTのwikiにも書いてありますがあらゆるセンサの時系列情報を累積的に取り込むので、全センサ情報を有効活用しますよ、という懐の深さを持っています。
(ただ当然DSTの方が複雑かつ計算コストは増えます)

おわりに


以上、いまいち分かりづらいDSTを噛み砕いてみましたが、簡略化しすぎてそんなに正確な説明ではありません。
DST面白そうやん、と思った方は気合を入れてwikiを読むことをオススメします。
(codingはIn Progressです、またいずれ。。。)

おわり。


2017年5月27日土曜日

Udacity自動運転コースのすゝめ

Term1終わったので感想をまとめます。

はじめに


大体のことはこちらに書いてありますので、各プロジェクトの難しいところだけまとめます。

Project 1&4: レーン検知もろすぎる問題


  • Project 1ではハフ変換やキャニーエッジ検知
  • Project 4ではSobelやwarp変換や曲線近似

などなど実装しましたが、上記動画の通りです。
白線以外のエッジを見てしまったり、
林道ではRegion of interest (注目領域)の決定が難しかったり、
この作り込みは相当大変(というかやりたくn...)

Project 3: ジグザグしすぎ問題


冒頭の動画はかなり極端な例ですが、どれだけdata augmentationをしても層を増やしてもこのジグザグはなくなりません。これは時系列処理をせず入力画像をCNNに投げてる構造が原因です。どうやってジグザグなくそうか、という課題は未だ未解決です。

Project 2 (標識認識): 画像暗いと認識できない問題


LeNetという割と古いCNN使っても91.3%とか高精度出ちゃいますが、暗い画像が難しいです。
が、優秀な学生は99%とか出してるので解決策はありそうです(要勉強)
alt text


Project 5 (車検知): 検知だけでは精度低い問題

冒頭動画の通り、SVMの検知だけだと半分も捉えられていない、というイメージです。
Trackingとかシコシコ実装しても良いんですけど、
YOLOv2で下記動画の通りなので、これで良いじゃん!と思ってしまうこの頃。

おわりに

以上、Term1の大まかな感想でした。
Project 2と5の問題は世間的に解決済みですが、

  • レーン検知の精度をどう上げるか (Project 1&4)
  • End-to-end learningのジグザグ解消 (Project 3)

の二つは個人的にかなりムズいと思いますし、
だからこそこの課題をudacityは提供したのかな、とか感じました。

Term 2ではレーダー、ライダーの扱い方やってますので、またいずれ。
おわり。